Die Rezepte zur Schnittstelle beantworten, welche Anfrage zu welcher Frage passt. Hier steht die andere Hälfte: was eine Oberfläche mit den Antworten macht. Die Beispiele stammen aus der Demoanwendung dieses Repositories, beschreiben aber Muster und keine Komponenten — nachbauen lässt sich jedes davon in einer fremden Anwendung.
Dieses Dokument gehört zu dieser Seite und wird hier gepflegt, nicht in
indibit-eu/tba3.
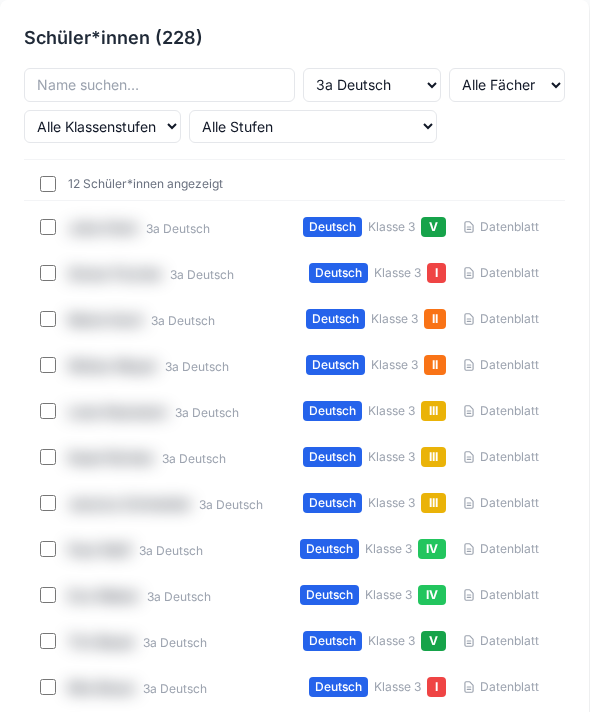
Individualergebnisse zeigen, ohne Namen zu zeigen: der Observer-Modus
Die Lage
Auswertungen auf Individualebene werden selten allein gelesen. Sie liegen in der Klassenkonferenz auf dem Beamer, sie gehen in einer Bildschirmfreigabe durch eine Videokonferenz, sie stehen in einem Screenshot an einem Fehlerbericht — und jemand schaut mit, der zu den Zahlen befugt ist, aber nicht zu den Namen dahinter.
Die naheliegende Antwort — in solchen Lagen eben keine Individualebene zeigen — beendet das Gespräch, bevor es anfängt. Wer über Förderbedarf spricht, braucht die einzelne Zeile; die Verteilung über die Gruppe sagt darüber nichts. Gesucht ist also nicht weniger Inhalt, sondern derselbe Inhalt ohne den Namen.
Der Schalter
Im Kopf der Demoanwendung sitzt dafür ein Schalter mit einem Auge, beschriftet mit
„Namen“ bzw. „Observer“ (apps/demo/src/components/layout/Header.jsx). Ein Klick
legt die ganze Anwendung um — nicht eine einzelne Ansicht, denn der Beamer zeigt
auch die nächste.
Der Zustand liegt neben den Filtern im FilterContext
(apps/demo/src/context/FilterContext.jsx), weil jede Ansicht, die Namen zeigt,
ohnehin schon an diesem Kontext hängt:
const { observerMode } = useFilters();

<span className={observerMode ? 'blur select-none' : ''}>
  {student.firstName} {student.lastName}
</span>
Zwei Klassen, nicht eine: blur zeichnet weich, select-none verhindert, dass man
den unleserlichen Namen mit der Maus markiert und in die Zwischenablage zieht.
Was verdeckt wird
| Ort | im Normalfall | im Observer-Modus |
|---|---|---|
| Schülerliste | Vor- und Nachname | weichgezeichnet |
| Mitgliederliste einer eigenen Gruppe | Vor- und Nachname | weichgezeichnet |
| Auswahlliste im Gruppeneditor | Vor- und Nachname | weichgezeichnet |
| Datenblatt (Modal und Vollansicht) | Name als Überschrift | weichgezeichnet |
| Schüler-Karte, Punktbeschriftung | Initialen (AM) |
•• |
| Schüler-Karte, Tooltip | Name | weichgezeichnet |
Die Punktbeschriftung ist der Fall, an dem der einfache Weg nicht reicht: zwei
Initialen sind auch weichgezeichnet noch zwei Zeichen an einer bekannten Stelle,
und in einer Klasse von zwölf sind sie damit so gut wie der Name. Deshalb werden
sie ersetzt statt verwischt (StudentMapCard.jsx) — wo die Verdeckung wenig
Material hat, muss sie das Material wegnehmen.
Was mit Absicht stehen bleibt
Klasse, Fach, Klassenstufe, Kompetenzstufe und die Kovariaten bleiben lesbar. Das ist der Punkt der Übung: verdeckt wird die Person, nicht das Ergebnis.
Damit ist auch gesagt, wogegen der Modus nicht schützt. Wer die Klasse kennt, kann aus Klasse, Geschlecht und Sprache zu Hause oft genug auf die Person schließen — in einer Gruppe von zwölf reicht manchmal eine Kovariate. Der Observer-Modus schützt gegen den Blick von jemandem, der die Gruppe nicht kennt: gegen den Beamer im vollen Raum, die Bildschirmfreigabe, den Screenshot. Gegen die Kollegin, die die Klasse unterrichtet, schützt keine Unkenntlichmachung, die die Ergebnisse stehen lässt.
Was der Modus nicht leistet
- Der Name steht weiter im DOM.
blurist ein Darstellungsfilter, keine Schwärzung: in der Entwicklerkonsole, im Quelltext der Seite und für Vorlesesoftware ist der Name unverändert da. Das ist die Grenze zwischen „nicht sichtbar“ und „nicht vorhanden“, und der Modus liegt auf der ersten Seite. - Der Export trägt den Klarnamen. Das PDF einer Einzelrückmeldung schreibt
Name und Dateinamen unverändert (
apps/demo/src/utils/studentPdfExport.js), auch bei eingeschaltetem Observer-Modus. Vertretbar ist das, weil eine Rückmeldung an die Person selbst geht und ein namenloses PDF dort nutzlos wäre — eine ausdrückliche Entscheidung ist es bisher nicht. Wer das Muster übernimmt, trifft sie besser bewusst. - Der Schalter überlebt kein Neuladen. Er liegt in
useStateund nicht in der Adresszeile: nachF5stehen die Namen wieder da, und ein geteilter Deeplink trägt den Modus nicht mit. Für einen Schalter, der im Gespräch umgelegt wird, ist das brauchbar; als Voreinstellung einer Rolle „Beobachter“ wäre es zu wenig.
Wo die Grenze wirklich liegt
Beim liefernden System. Die Schnittstelle verlangt keinen Klarnamen: name an der
Wertegruppe heißt in der Spezifikation „Bezeichnung der Wertegruppe“, und das
Beispiel dort ist bereits Schüler 1. Ob eine Antwort mit type=students einen
Namen, ein Kürzel oder ein Pseudonym trägt, entscheidet also die Stelle, die sie
ausliefert — nicht die Oberfläche, die sie anzeigt. Zu den Wertegruppen und zu
type siehe die Endpunkt-Referenz.
Die Demoanwendung selbst hat gar keine echten Namen: sie erfindet sie deterministisch
im Browser (apps/demo/src/utils/studentData.js), damit eine Oberfläche mit Namen
überhaupt zu sehen ist. Der Observer-Modus schützt hier also nichts — er zeigt ein
Muster, das in einer echten Anwendung etwas zu schützen hätte.
Daraus folgt die Reihenfolge für ein echtes Vorhaben:
- Liefere keine Namen, wo keine gebraucht werden — die Pseudonymisierung gehört ins Backend, nicht in ein CSS-Filter.
- Zeige die Namen nur dort, wo die Rolle sie braucht (die Klassenleitung braucht sie, die Schulaufsicht nicht).
- Und für die Momente, in denen jemand mitschaut, gibt es zusätzlich einen Schalter wie diesen.
Der Observer-Modus ist Schritt 3. Er ersetzt die Schritte 1 und 2 nicht.
Nachbauen
Drei Zutaten, unabhängig vom Framework:
- Ein Merker an einer Stelle, die jede Ansicht schon kennt — Kontext, Store, was die Anwendung eben hat. Pro Ansicht ein eigener Schalter wäre falsch: wer ihn umlegt, will ihn überall umgelegt haben.
- Eine Regel, was er trifft. Die kurze Fassung: den Namen, sonst nichts. Alles andere ist Ergebnis und soll lesbar bleiben.
- Eine Sonderbehandlung für Kurzformen. Initialen, Kürzel, Avatare mit Buchstaben — überall dort, wo wenig Zeichen an einer festen Stelle stehen, ersetzen statt weichzeichnen.
Und eine vierte, die leicht vergessen wird: ein Test, der beides prüft — dass der
Name verdeckt ist und dass das Ergebnis daneben noch dasteht. In diesem
Repository tut das e2e/demo-schueler.spec.js gegen den ausgelieferten Stand.
Eine Rückmeldung, die das Haus verlässt: der PDF-Export
Die Lage
Eine Auswertung, die nur im Browser steht, hilft in der Elternsprechstunde nicht und im Ordner der Klassenleitung auch nicht. Irgendwann muss etwas herausfallen, das man ausdrucken, weiterreichen und ablegen kann — und das ohne die Anwendung noch lesbar ist.
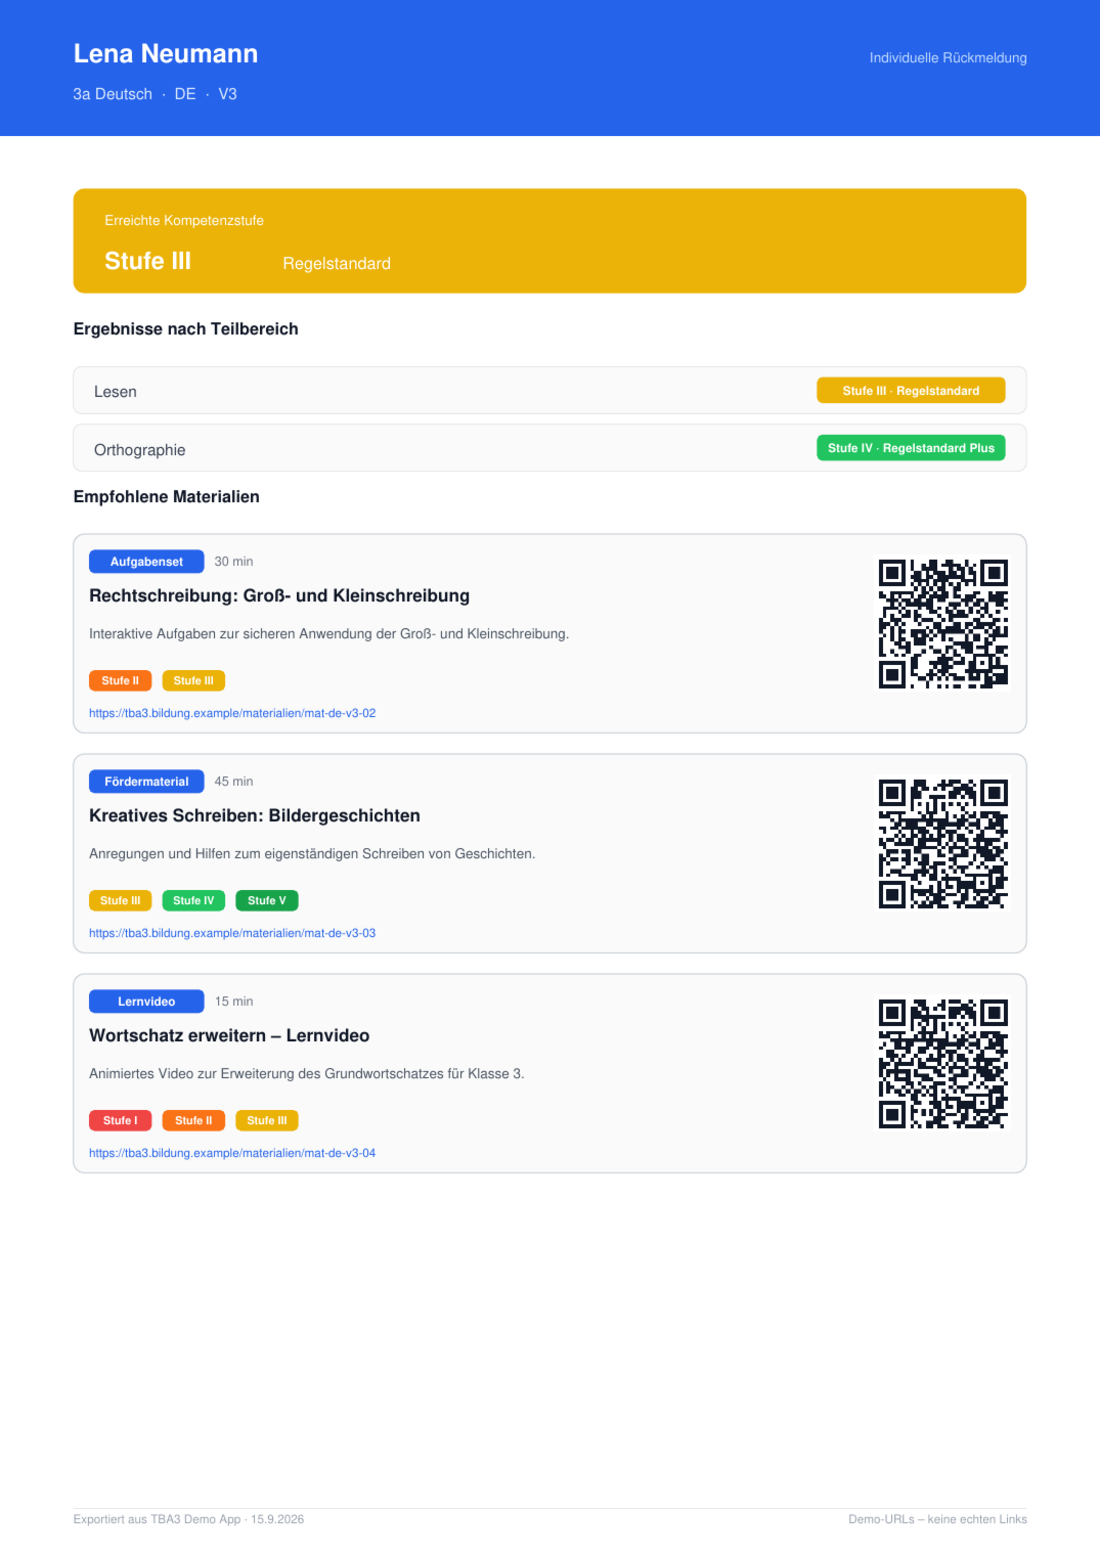
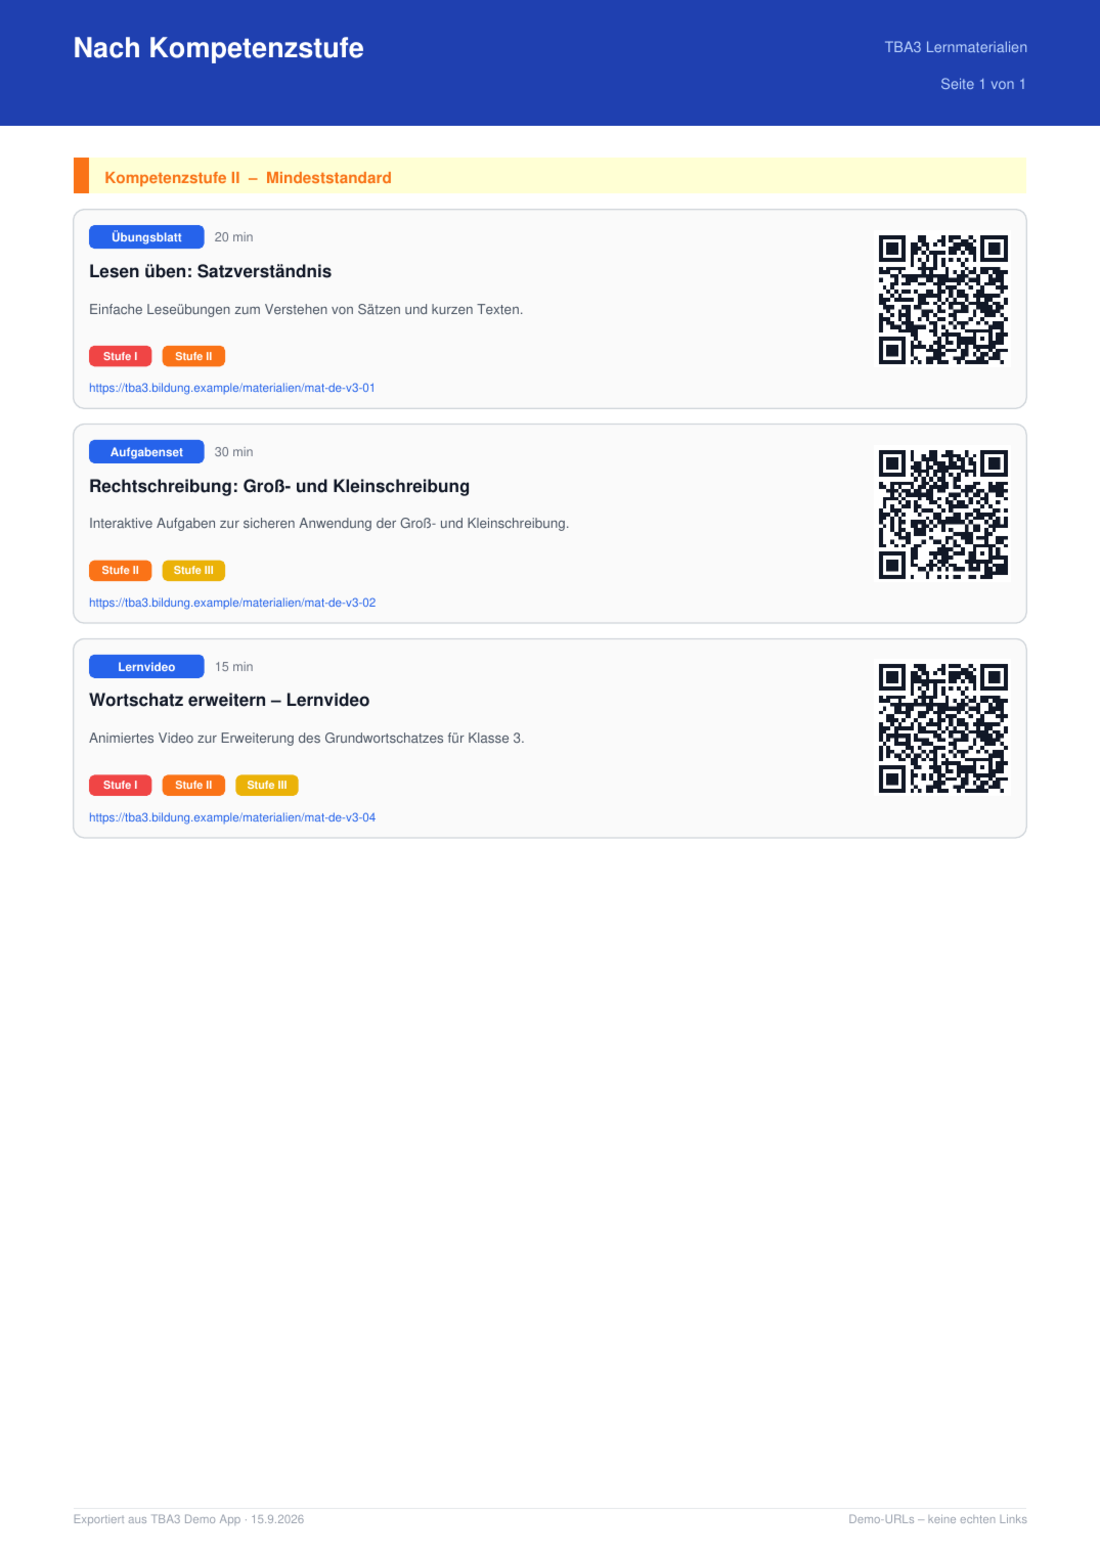
Die Demoanwendung erzeugt zwei PDFs. Sie sehen gleich aus, weil sie dieselben Zeichenhelfer benutzen, beantworten aber verschiedene Fragen:
| individuelle Rückmeldung | Materialzuordnung | |
|---|---|---|
| Auslöser | Knopf im Datenblatt einer Person | Knopf in der Materialansicht |
| Modul | studentPdfExport.js |
pdfExport.js |
| Umfang | eine Seite je Person | eine Seite je Gruppe, plus Trennseiten |
| Inhalt | erreichte Stufe, Ergebnisse nach Teilbereich, empfohlene Materialien | zugewiesene Materialien nach Kompetenzstufe |
| Dateiname | Rueckmeldung_{Nachname}_{Vorname}.pdf |
tba3_{Gruppe}_{Datum}.pdf |
Daneben steht derselbe Stoff als Common Cartridge (.imscc,
commonCartridgeExport.js) — für das Lernmanagementsystem statt für den Drucker.
Das PDF ist die Ausgabe für Menschen, die Cartridge die für Maschinen; wer nur
eine von beiden baut, baut fast sicher die falsche.
Alles im Browser, nichts auf einem Server
Beide Ausgaben entstehen im Browser. Kein Byte der Rückmeldung geht dafür an einen Dienst, es gibt keinen Export-Endpunkt und keine Zwischenablage auf fremder Infrastruktur — was das Gerät verlässt, ist die Datei im Download-Ordner.
Das ist keine Nebensache, sondern der Grund, warum diese Bauweise für Individualdaten überhaupt in Frage kommt. Ein serverseitiger PDF-Dienst müsste Namen und Ergebnisse entgegennehmen, und damit begänne eine ganz andere Diskussion — Auftragsverarbeitung, Aufbewahrung, Löschfristen. Wer den Export später doch auf einen Server zieht, verschiebt nicht nur Rechenlast.
Geladen wird erst beim Klick
jsPDF ist groß. Deshalb kommt es nicht in das Bündel, das beim Start geladen wird, sondern erst, wenn jemand wirklich exportiert:
const handleDownloadPDF = async () => {
  setPdfLoading(true);
  try {
    const { exportStudentPDF } = await import('../../utils/studentPdfExport');
    await exportStudentPDF(student);
  } finally {
    setPdfLoading(false);
  }
};
Die Größenordnung: das Hauptbündel der Demoanwendung liegt bei rund 870 KB, der nachgeladene Brocken mit jsPDF und dem QR-Erzeuger bei rund 410 KB, der für die Common Cartridge bei rund 100 KB. Statisch eingebunden wüchse der erste Seitenaufruf also um gut die Hälfte — für eine Funktion, die die meisten Besuche nie anfassen.
Das finally gehört dazu: ohne es bliebe der Knopf nach einem Fehler für immer
im Ladezustand.
Ein nachgeladener Brocken bringt eine eigene Fehlerquelle mit — er kann im Build
fehlen oder unter einem falschen Pfad liegen, und beides fällt in der Entwicklung
nicht auf. Die E2E-Tests warten deshalb auf das Download-Ereignis
(e2e/demo-schueler.spec.js, e2e/demo-materialien.spec.js): eine Datei, die
ankommt, ist zugleich der Nachweis, dass der Brocken ausgeliefert wird.
Die Sprache wird beim Klick geholt, nicht beim Laden des Moduls
Die beschrifteten Konstanten stehen auf Modulebene, werden aber zu Beginn jedes Exports neu geholt:
let { COMPETENCE_LEVELS, GRADES, SUBJECTS } = konstantenJetzt();

export const exportStudentPDF = async (student) => {
  ({ COMPETENCE_LEVELS, GRADES, SUBJECTS } = konstantenJetzt());
  // …
};
Das sieht nach doppelter Arbeit aus und ist der Kern der Sache: das Modul wird
beim ersten Export geladen, die Sprache kann danach noch umgeschaltet werden.
Ohne die zweite Zeile stünde im PDF die Sprache, die beim ersten Klick galt —
und niemand käme auf die Idee, das dem Modul-Ladezeitpunkt zuzuschreiben. Alles,
was außerhalb einer Komponente übersetzt wird, ruft uebersetze() deshalb beim
Aufruf statt beim Import.
Was die Standardschrift kann — und was nicht
jsPDF bringt die 14 Standardschriften von PDF mit; benutzt wird Helvetica. Die deckt Westeuropa ab: Umlaute, Akzente, das ß stehen richtig da. Emoji stehen nicht da, sondern als Müll — und die Materialarten der Demoanwendung tragen in der Oberfläche welche.
Deshalb geht jede Zeichenkette durch safe(), bevor sie ins PDF kommt:
export const safe = (str) =>
  String(str ?? '').replace(
    /[\u{1F000}-\u{1FFFF}]|[\u{2600}-\u{27BF}]|[\u{FE00}-\u{FE0F}]|\u{FEFF}/gu,
    ''
  ).trim();
Das ist die billige Lösung und für diesen Zweck die richtige: Emoji sind hier
Schmuck. Sobald aber Namen ins Spiel kommen, die nicht in WinAnsi passen —
kyrillisch, griechisch, türkisches ı, polnisches ł —, hilft Wegwerfen nicht mehr,
denn dann wirft man den Namen weg. Dann führt kein Weg an einer eingebetteten
Schrift vorbei (pdf.addFileToVFS und pdf.addFont), und das Bündel wächst um
die Schriftdatei. Für ein Vorhaben mit echten Schülerdaten ist das die
Voreinstellung, nicht die Ausnahme.
QR-Codes vorab, weil das Zeichnen synchron ist
Jede Materialkarte trägt einen QR-Code. Die Erzeugung ist asynchron, das Setzen
ins PDF nicht — pdf.addImage nimmt keine Zusage entgegen. Also werden die Codes
erzeugt, bevor die Zeichenschleife beginnt:
const qrCodes = await Promise.all(
  materialien.map((m) => generateQR(m.url || getMaterialUrl(m)).catch(() => null))
);
Zwei Entscheidungen in zwei Zeilen: alle auf einmal statt nacheinander, und ein
catch, das null liefert. Ein QR-Code, der nicht zustande kommt, lässt die
Karte ohne Bild — er lässt nicht den ganzen Export scheitern. Bei einem Vorgang,
den jemand angestoßen hat und auf dessen Ergebnis er wartet, ist die Teilausgabe
fast immer besser als die Fehlermeldung.
Wohin die Codes zeigen, ist in der Demoanwendung ausdrücklich nichts:
https://tba3.bildung.example/materialien/{id} ist eine Platzhalteradresse, und
die Fußzeile jeder Seite sagt es — „Demo-URLs – keine echten Links“. Eine
Papierausgabe überlebt ihren Anlass um Jahre; ein toter Link darin, der nicht als
solcher gekennzeichnet ist, schickt jemanden in die Irre, der die Herkunft des
Blattes längst vergessen hat.
Der Seitenumbruch wird selbst gerechnet
jsPDF hat keinen Textfluss. Es gibt einen Zeiger y, und wer zeichnet, schiebt
ihn weiter. Ob der nächste Block noch auf die Seite passt, muss vor dem
Zeichnen geprüft werden:
if (y + CARD_H > PAGE_H - 16) {
  drawFooter(pdf, datum);
  pdf.addPage();
  y = MARGIN;
}
drawMaterialCard(pdf, material, y, qrCodes[i]);
y += CARD_H + 4;
Die Fußzeile wird dabei auf der alten Seite gezogen, bevor die neue beginnt.
Wer sie am Ende in einem Rutsch setzen will, muss alle Seiten noch einmal
durchgehen — und vergisst die letzte. Die Blockhöhen stehen deshalb als
Konstanten (CARD_H, LEVEL_BAR_H, HEADER_H) und nicht als Zahlen im
Zeichencode: eine Kartenhöhe, die an zwei Stellen gepflegt wird, bricht die Seite
irgendwann an der falschen Stelle um.
Was der Export nicht tut
- Der Observer-Modus greift nicht. Die individuelle Rückmeldung trägt den Klarnamen im Kopf und im Dateinamen, auch wenn die Oberfläche gerade alle Namen weichzeichnet. Für eine Rückmeldung an die Person selbst ist das richtig — ein namenloses Blatt ließe sich nicht zuordnen. Als stille Ausnahme von einem Schutz, den man eingeschaltet hat, ist es trotzdem eine Entscheidung, die ausdrücklich getroffen gehört; siehe Observer-Modus.
- Geprüft wird die Datei, nicht ihr Inhalt. Die E2E-Tests belegen, dass ein Klick eine PDF-Datei mit dem erwarteten Namen liefert. Ob die richtige Kompetenzstufe darin steht, prüft kein Test — dafür müsste man das PDF wieder auslesen. Wer den Inhalt absichert, tut das am besten eine Ebene tiefer, an den Funktionen, die die Werte aufbereiten.
- Es gibt keine Vorschau. Der Klick erzeugt die Datei und stößt den Download an; was darin steht, sieht man erst im Betrachter.
Nachbauen
- Erst beim Klick laden. Eine PDF-Bibliothek gehört nicht in das Bündel, das jeder Besuch zahlt.
- Übersetzen beim Aufruf, nicht beim Import. Sonst friert die Ausgabe die Sprache des ersten Klicks ein.
- Schrift vor Inhalt klären. Welche Zeichen im Dokument vorkommen können, entscheidet, ob die Standardschrift reicht — und diese Frage stellt man vor dem ersten Layout, nicht nach dem ersten Bericht über kaputte Namen.
- Alles Asynchrone vor die Zeichenschleife. Bilder, QR-Codes, nachgeladene Daten — die Schleife selbst bleibt synchron und damit lesbar.
- Teilausgabe schlägt Fehlermeldung. Was schmückt, darf fehlen; was trägt, muss da sein.
Ein Assistent, der die Auswertung lesen kann: der MCP-Server
Pilot, kein Produkt. Was hier steht, ist im Rahmen der Machbarkeitsstudie entstanden und beantwortet eine Frage — geht das überhaupt, und was wäre dafür nötig? — und keine andere. Es ist keine Empfehlung für den Betrieb, kein Bestandteil der Schnittstelle und nichts, worauf sich ein Vorhaben stützen sollte, ohne die Fragen im Abschnitt „Was ein echter Betrieb lösen müsste“ vorher beantwortet zu haben.
Die Idee
Eine Auswertungsschnittstelle beantwortet die Fragen, die jemand beim Entwurf der Oberfläche vorhergesehen hat. „Welche Aufgabenformate liegen in 8b unter dem Landesschnitt, und gibt es dazu Material?“ ist keine davon — die Frage kreuzt drei Endpunkte und einen Katalog, und für jede solche Kreuzung eine Ansicht zu bauen, hört nie auf.
Das Model Context Protocol dreht die Richtung um: statt die Frage vorwegzunehmen, beschreibt man dem Sprachmodell die verfügbaren Abfragen, und es setzt sie zusammen. Der Pilot prüft, ob sich die TBA3-Endpunkte so beschreiben lassen, dass dabei etwas Brauchbares herauskommt.
Was der Server anbietet
Sieben Werkzeuge (mcp-server/server-impl.js). Wie man sie startet, einbindet
und welche Umgebungsvariablen es gibt, steht im README des Pakets; hier steht,
was dahintersteckt:
| Werkzeug | dahinter |
|---|---|
tba3_list_entities |
Schulen, Lerngruppen, Bundesländer — fest eingebaut, nicht aus der Schnittstelle |
tba3_list_subjects |
die vier Fächer |
tba3_list_grades |
Klasse 3 und Klasse 8 |
tba3_get_competence_levels |
GET /{ebene}/{id}/competence-levels |
tba3_get_aggregations |
GET /{ebene}/{id}/aggregations |
tba3_get_items |
GET /{ebene}/{id}/items |
tba3_list_materials |
ein fest eingebauter Materialkatalog, kein Endpunkt |
Vier beantworten „was gibt es?", drei „wie sieht es aus?". Die Trennung ist der
Grund, warum das Ganze überhaupt funktioniert: ein Modell, das eine Kennung wie
8b-mathe raten muss, rät — und zwar plausibel und falsch. Die drei
get-Werkzeuge reichen an die Schnittstelle durch, jedes mit entityType,
entityId und dem type-Parameter.
Die Hilfe-Ansicht der Demoanwendung führt nur sechs davon auf:
tba3_list_materials fehlt in ihrer Tabelle. Zwei Listen, die auseinanderlaufen
können, sind eine zu viel — wer den Server erweitert, denkt an die Ansicht
in apps/demo/src/components/HelpView.jsx mit.
Zwei Wege hinein
Derselbe Server (createMcpServer()), zwei Transporte:
- stdio (
index.js) — der Weg für eine Entwicklungsumgebung auf demselben Rechner. Der Client startet den Prozess selbst, es gibt keinen Port und keine Netzwerkgrenze. - Streamable HTTP (
server-http.js) — der Weg für ein Deployment.POST /mcp, bewusst ohne Sitzung (sessionIdGenerator: undefined): je Anfrage entsteht eine Server-Instanz, die danach wieder verschwindet. Das macht den Dienst beliebig vervielfachbar und heißt zugleich, dass er sich nichts merkt — auch nichts, woran er einen Aufrufer wiedererkennen könnte.
Dass der Kern von beidem nichts weiß, ist die eigentliche Arbeit an dieser Aufteilung: die Werkzeuge werden einmal beschrieben, und welcher Transport sie trägt, entscheidet die Betriebsart.
Wo er läuft — und wo nicht
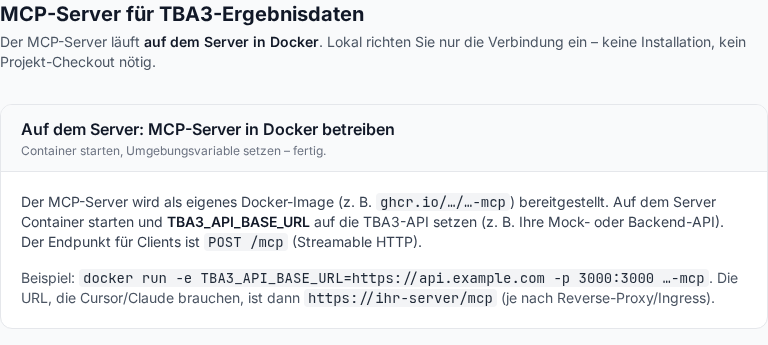
Im Docker-Abbild: docker-entrypoint.sh startet ihn auf Port 3000, nginx
reicht /mcp dorthin durch, TBA3_API_BASE_URL zeigt standardmäßig auf den Mock
im selben Container. Das Abbild wird zusätzlich einzeln gebaut
(ghcr.io/FWU-DE/tba3-demo-app-mcp), damit man den Server ohne die Seite
betreiben kann.
Nicht auf dem öffentlichen Deployment: vercel.json kennt keine Route /mcp,
und eine Funktion, die MCP spräche, gibt es dort nicht. Die Hilfe-Ansicht bildet
die Adresse aber aus window.location.origin — auf der öffentlichen Seite zeigt
sie deshalb eine Adresse, die niemand beantwortet, solange
VITE_MCP_HTTP_URL beim Bauen nicht auf ein echtes Deployment gesetzt wird. Wer
den Pilot vorführt, führt ihn aus dem Container vor, nicht aus dem Browser.
Was ein echter Betrieb lösen müsste
Der Pilot beantwortet die technische Frage mit ja. Die Fragen, die er offenlässt, sind die schwereren — und sie sind nicht Restarbeit, sondern Vorarbeit:
- Es gibt keine Authentifizierung. Wer
/mcperreicht, erreicht jede Lerngruppe, jede Schule, jedes Land. Der Pilot steht hinter nichts als der Erreichbarkeit seines Containers. - Es gibt keinen Aufrufer. Der Server spricht die Schnittstelle ohne jede Identität an. Er könnte also gar nicht auf „Ihre Klasse“ einschränken, selbst wenn er wollte — eine Rollen- und Rechteschicht fehlt nicht, sie ist nicht vorgesehen.
- Individualdaten gehen an ein Sprachmodell. Alle drei Datenwerkzeuge nehmen
type=studentsentgegen. Was dann zurückkommt, geht an den Client und damit an das Modell dahinter — je nach Einsatz an einen fremden Dienst. Das ist die Entscheidung, die vor der ersten Zeile Code gehört, nicht nach dem Prototyp; siehe Observer-Modus, wo dieselbe Grenze von der anderen Seite beschrieben ist. - Der Server ist ungetestet.
mcp-server/ist bewusst kein Workspace — eigener Lockfile, eigener Docker-Kontext — und hängt damit auch nicht annpm test. Für einen Pilot vertretbar; für einen Dienst, der Ergebnisdaten herausgibt, nicht. - Das Verzeichnis ist eingebaut, nicht abgefragt. Lerngruppen, Schulen,
Fächer, Jahrgänge und der Materialkatalog stehen in
server-impl.js. Für den Pilot ist das richtig und im README auch begründet: ein Werkzeug, das erst eine Anfrage stellen muss, um sagen zu können, welche Anfragen möglich sind, hilft niemandem. Offen bleibt trotzdem, woher ein echter Server das Verzeichnis nähme — die Schnittstelle kennt keinen Endpunkt, der Lerngruppen aufzählt, und für einen Aufrufer ohne Identität wäre die Antwort darauf auch nicht eindeutig.
Was sich daraus mitnehmen lässt
Unabhängig davon, ob am Ende ein MCP-Server steht:
- Nachschlagewerkzeuge zuerst. Ein Modell, das Kennungen raten muss, rät. Die drei Listenwerkzeuge kosten wenig und ändern die Trefferquote deutlich.
- Ein Werkzeug je Endpunkt, nicht ein Werkzeug je Frage. Die Fragen kommen ohnehin anders, als man sie vorwegnimmt — das war ja der Anlass.
- Den Kern vom Transport trennen. Was die Werkzeuge tun, hat mit stdio oder HTTP nichts zu tun, und getrennt lässt sich beides betreiben.
- Die Datenschutzfrage steht am Anfang, nicht am Ende. Ein Prototyp, der Individualdaten schon herausgibt, hat die Entscheidung stillschweigend getroffen.
Das Handwerkliche — Starten, Umgebungsvariablen, Einbinden in Claude Code oder Cursor, das Abbild aus der CI — steht im README des MCP-Pakets.